Projeto real
Observatório — Triagem de manifestações com IA e privacidade
Plataforma whitelabel que anonimiza manifestações de cidadãos, usa IA só como recomendação, coloca pessoas na decisão final e transforma tudo em indicadores sem expor ninguém.
- textos originais enviados à IA ou gravados no banco
- 0
- de confiança mínima para a IA classificar; abaixo disso, decide uma pessoa
- 70%
- fontes públicas de coleta, processadas em segundo plano
- 3
- testes automatizados entre API e interface
- 41
- Ano
- 2026
- Papel
- Full-stack & arquitetura
- Cliente
- Prova de conceito
- Tecnologias
- Python
- FastAPI
- PostgreSQL
- SQLAlchemy
- Presidio
- spaCy
- Gemini
- Playwright
- Next.js
- React
- TanStack Query
- Docker
Ouvidorias recebem todo dia reclamações, elogios, sugestões e denúncias por telefone, e-mail e portais. Esses textos costumam vir cheios de dados pessoais — nome, CPF, telefone — e alguém precisa ler um por um para decidir a área responsável e a urgência. É lento, e o gestor fica sem visão do todo.
O Observatório é uma prova de conceito para esse fluxo. Ele protege o texto antes de qualquer outra coisa, pede à IA uma classificação apenas como sugestão, manda os casos incertos para revisão humana, coleta manifestações de fontes públicas autorizadas em segundo plano e mostra indicadores agregados — nunca o conteúdo individual.
Construí as duas pontas: uma API em Python com worker de coletas e um front-end em Next.js. O produto é whitelabel: nome, slogan e descrição vêm de variáveis de ambiente, sem tocar em componentes. A seguir, a jornada real de um operador, com prints tirados do sistema rodando e dados fictícios.
1. Acesso restrito
Não existe cadastro público: só um administrador cria usuários. Há dois papéis — o operador trata manifestações e consulta coletas e indicadores; o administrador também gerencia usuários, catálogos, fontes e coletas.
O login passa por um BFF (back-end for front-end) dentro do próprio Next.js. Ele troca e-mail e senha por um JWT na API e guarda o token num cookie HttpOnly. O JavaScript do navegador nunca vê o token: cada chamada vai para o proxy do Next.js, que acrescenta o cabeçalho de autorização ao falar com a API.
- Senhas com Argon2; o token tem validade curta e é conferido pela API em toda chamada (assinatura, usuário e papel).
- O proxy também barra rotas administrativas para quem não é admin, como uma camada extra além da validação da API.
- A API impede excluir o próprio usuário e o último administrador.
2. Triagem: privacidade antes da IA
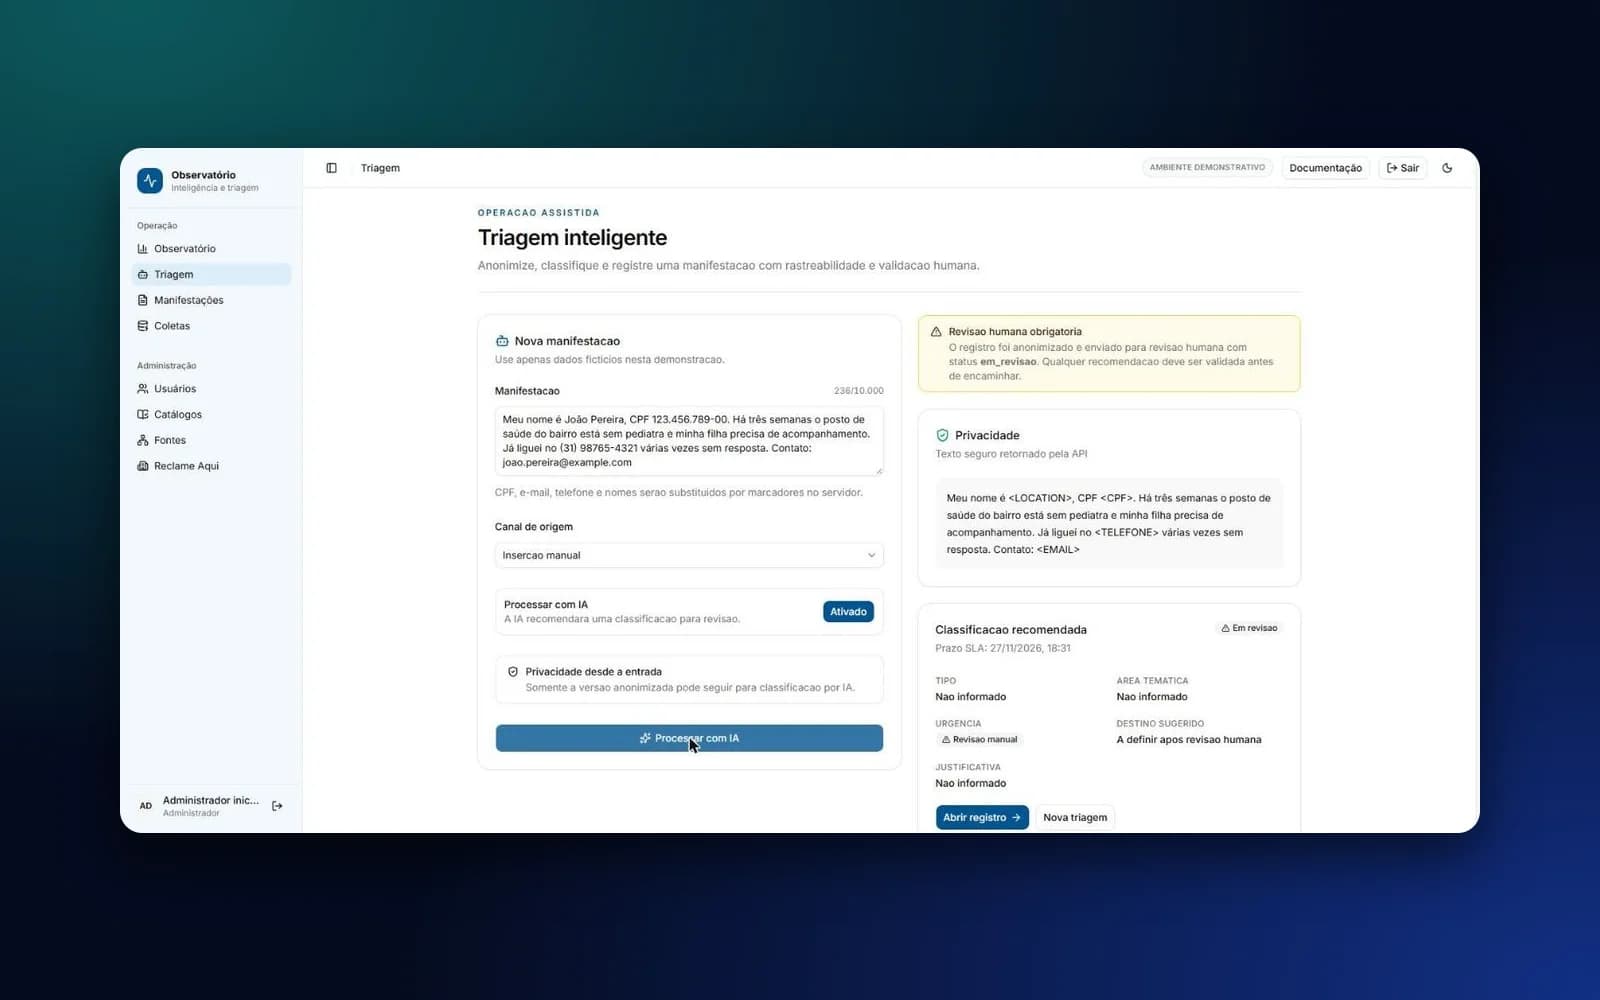
O operador cola a manifestação, escolhe o canal de origem e decide se quer a ajuda da IA. A regra que guia todo o resto: o texto é protegido no servidor antes de qualquer outra etapa, e só a versão protegida segue adiante.
A anonimização combina duas técnicas. O Microsoft Presidio, com o modelo de português do spaCy, reconhece entidades como nomes de pessoas. Regras próprias pegam formatos brasileiros: CPF, RG (inclusive o de Minas Gerais), telefone e e-mail. Depois, as mesmas expressões passam de novo sobre o resultado, como defesa em profundidade. Cada ocorrência vira um marcador: <CPF>, <EMAIL>, <TELEFONE>, <PESSOA>.
Para não registrar a mesma manifestação duas vezes, a API calcula um HMAC do texto normalizado e recusa repetições da mesma origem. O texto original nem chega a ser gravado: o campo fica nulo até existirem regras formais de criptografia e retenção.
def anonymize(text: str) -> str:
    results = get_analyzer().analyze(text=text, language="pt")
    anonymized = get_anonymizer().anonymize(
        text=text, analyzer_results=results, operators=operators,
    ).text
    # Defesa em profundidade para os formatos brasileiros.
    anonymized = re.sub(CPF_PATTERN, "<CPF>", anonymized)
    anonymized = re.sub(RG_PATTERN, "<RG>", anonymized)
    anonymized = re.sub(EMAIL_PATTERN, "<EMAIL>", anonymized)
    return re.sub(PHONE_PATTERN, "<TELEFONE>", anonymized)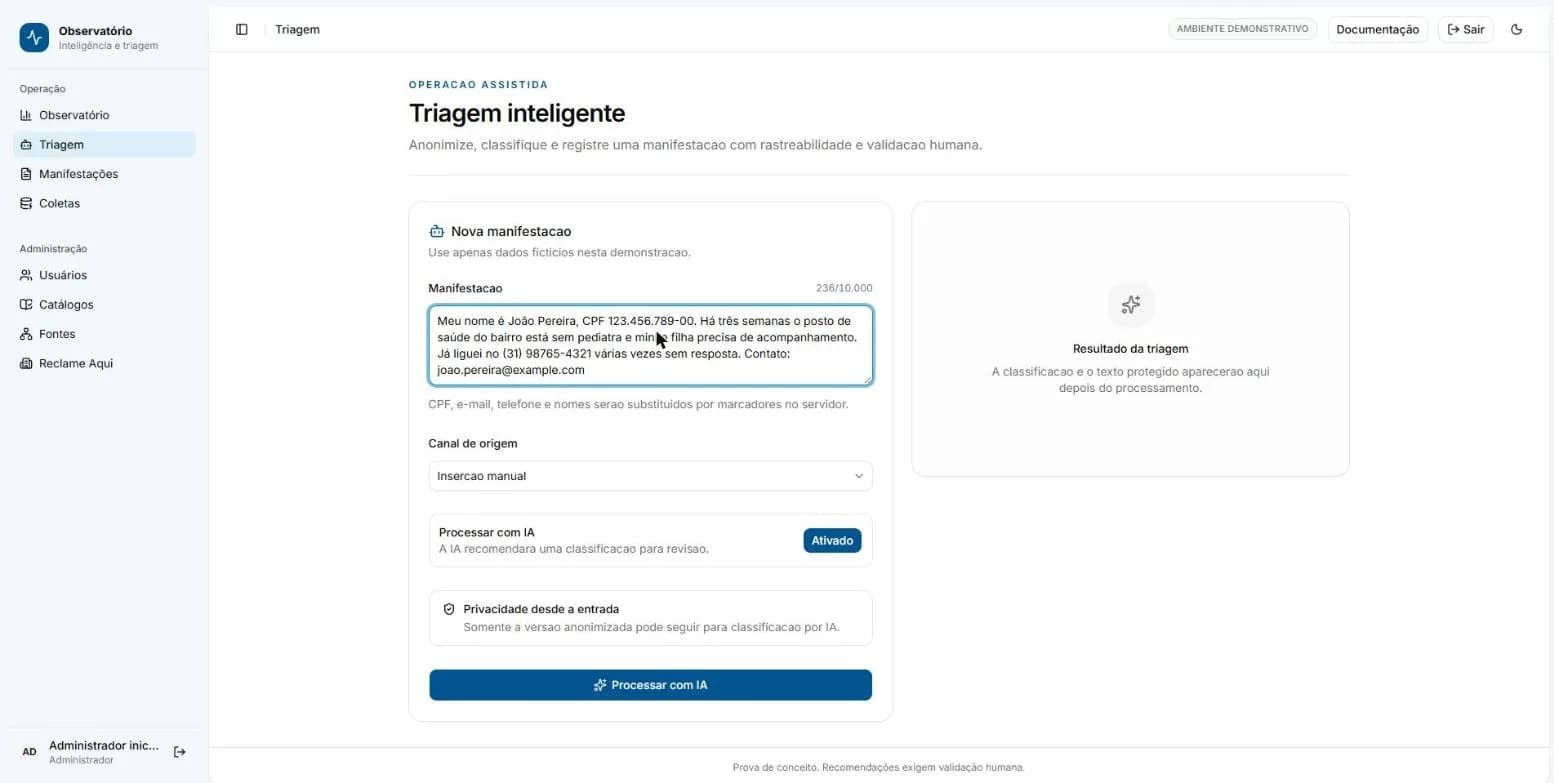
3. IA como recomendação, não como decisão
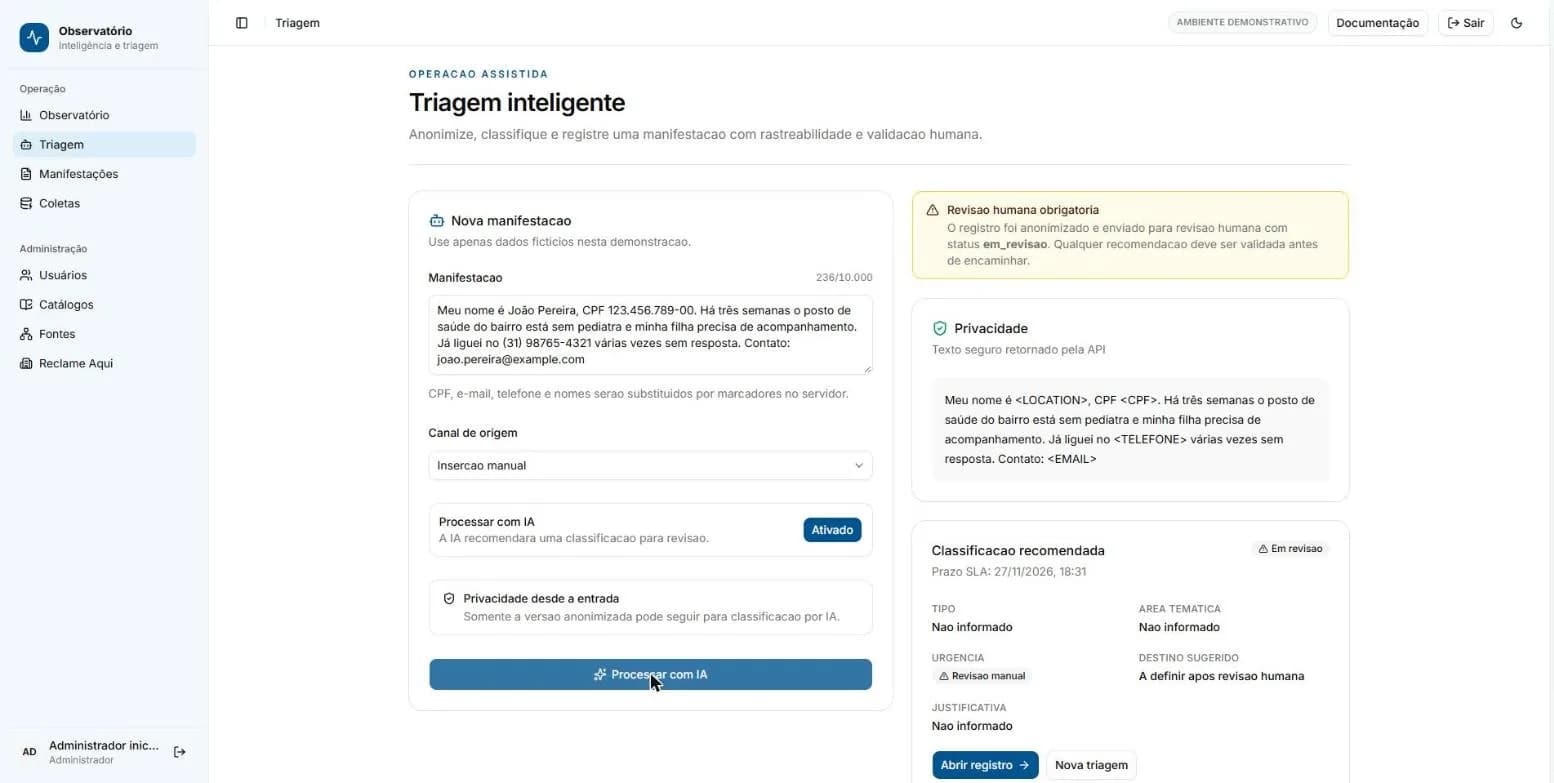
Quando a IA está ligada, o Gemini recebe apenas o texto anonimizado e o catálogo ativo de áreas e assuntos, com seus IDs. A resposta precisa vir em JSON estruturado — tipo (elogio, reclamação, sugestão ou denúncia), área, assunto, urgência, destino sugerido, justificativa e um grau de confiança —, validado por um schema Pydantic.
Um JSON bem formado não basta. A API confere se a área e o assunto existem, estão ativos e pertencem um ao outro. Se a confiança ficar abaixo de 70%, se o provedor falhar, se a resposta for inválida ou se não houver catálogo, a manifestação não recebe uma classificação forçada: fica em revisão humana.
Cada classificação guarda o modelo usado e a versão do prompt, para que seja possível auditar depois por que uma manifestação foi parar em determinada área.
classification, model = classify_text(anonymized_text, catalog)
if not is_valid_classification_pair(db, classification.area_id, classification.subject_id):
    raise LlmUnavailableError("Área e assunto fora do catálogo ativo.")

manifestation.requires_human_review = (
    classification.confidence < settings.llm_confidence_threshold  # 0.7
)
manifestation.status = (
    "em_revisao" if manifestation.requires_human_review else "classificado"
)
4. Revisão humana e prazos
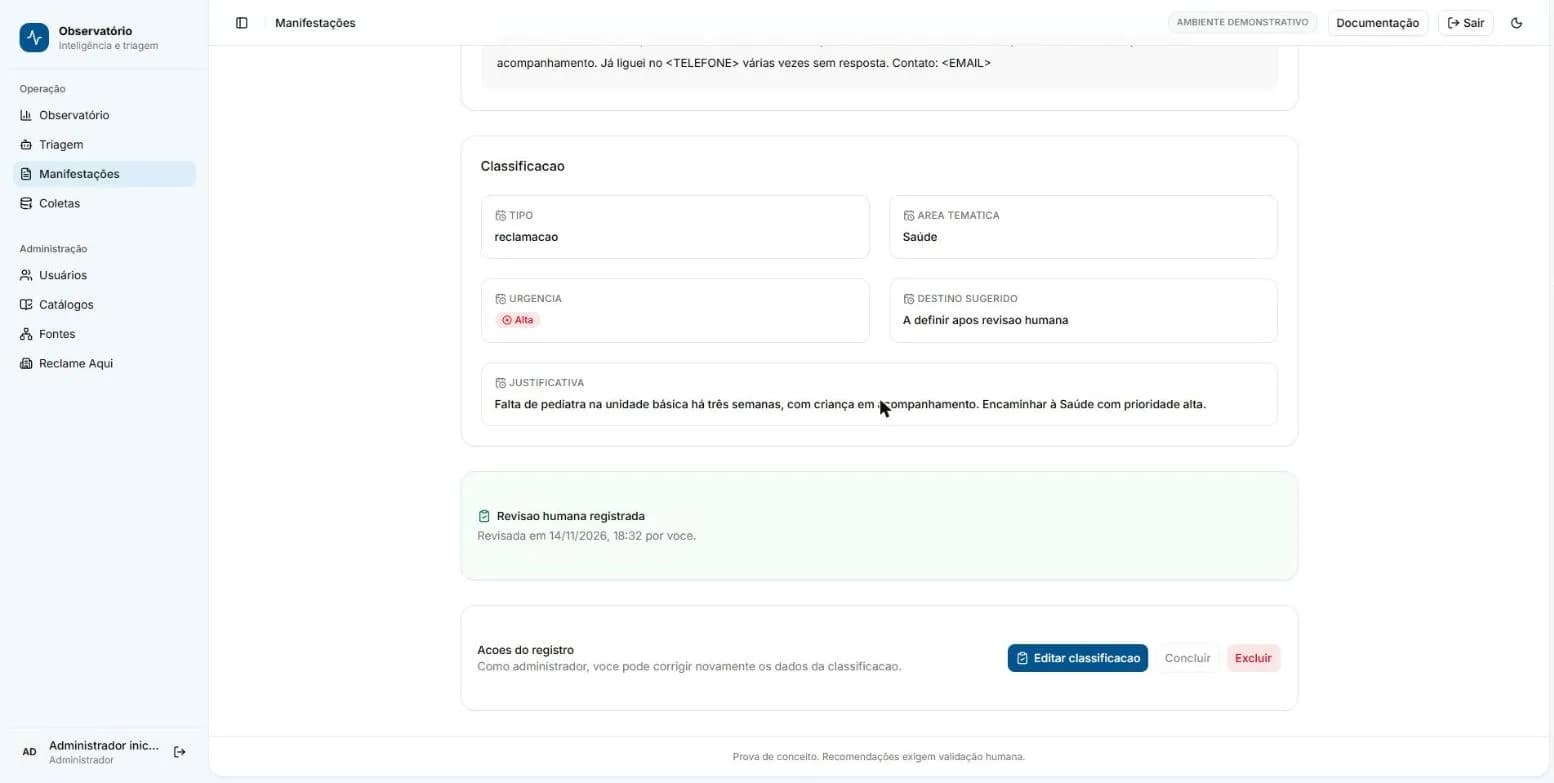
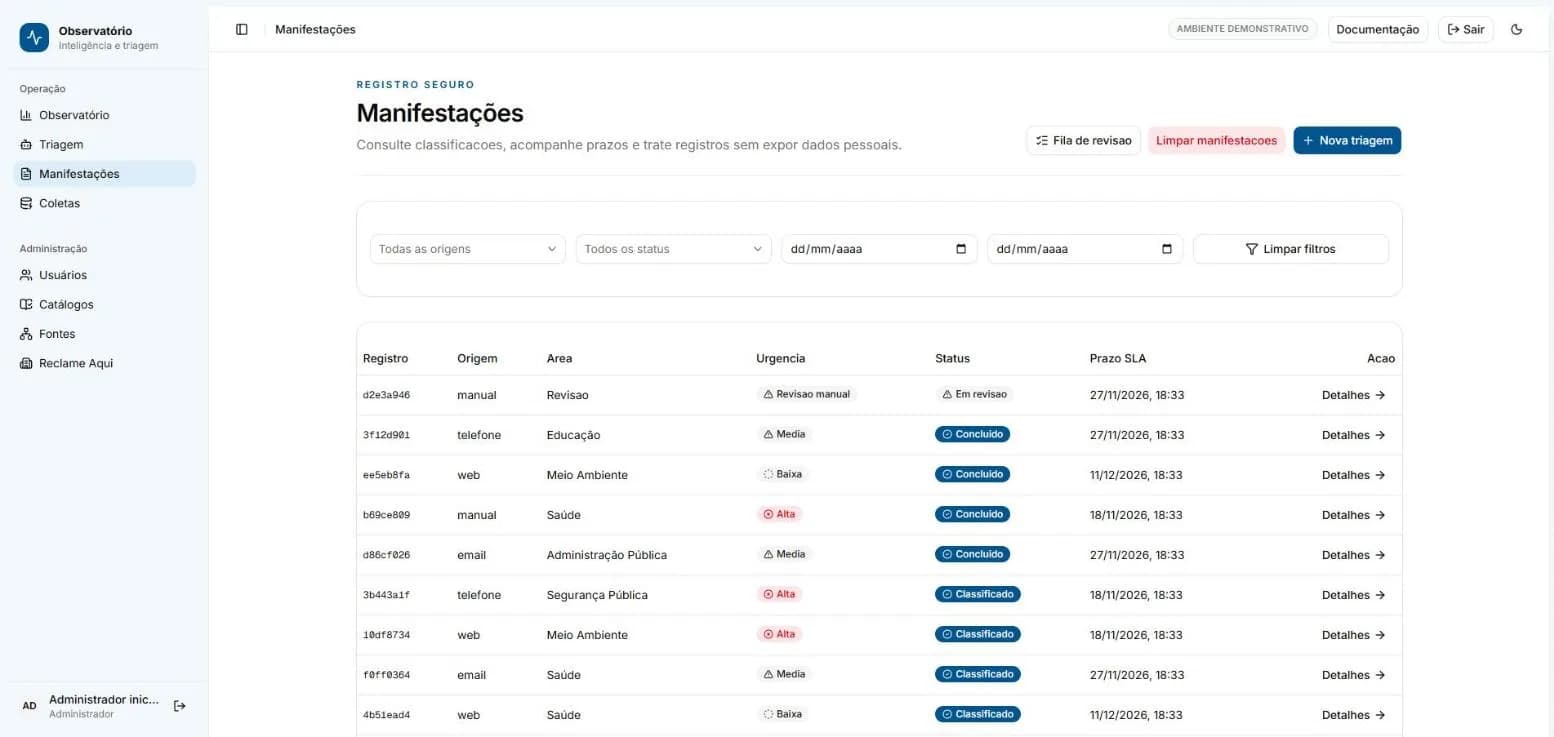
Tudo o que a IA não resolveu com segurança cai numa fila de revisão. O operador abre o registro, vê apenas o texto protegido e confirma área, assunto, tipo, urgência, destino e uma justificativa. A API valida de novo a combinação de área e assunto e registra quem revisou e quando.
A urgência define o prazo (SLA), contado em dias úteis: 3 para alta, 10 para média e 20 para baixa, com feriados configuráveis. O operador revisa itens pendentes; o administrador também pode corrigir um item já classificado — para o operador, essa tentativa retorna 403.
def sla_due_at(urgency: str, registered_at: datetime) -> datetime:
    days = {"alta": 3, "media": 10, "baixa": 20}.get(urgency, 10)
    due_at, added = registered_at, 0
    while added < days:
        due_at += timedelta(days=1)
        if due_at.weekday() < 5 and due_at.date().isoformat() not in holidays:
            added += 1
    return due_at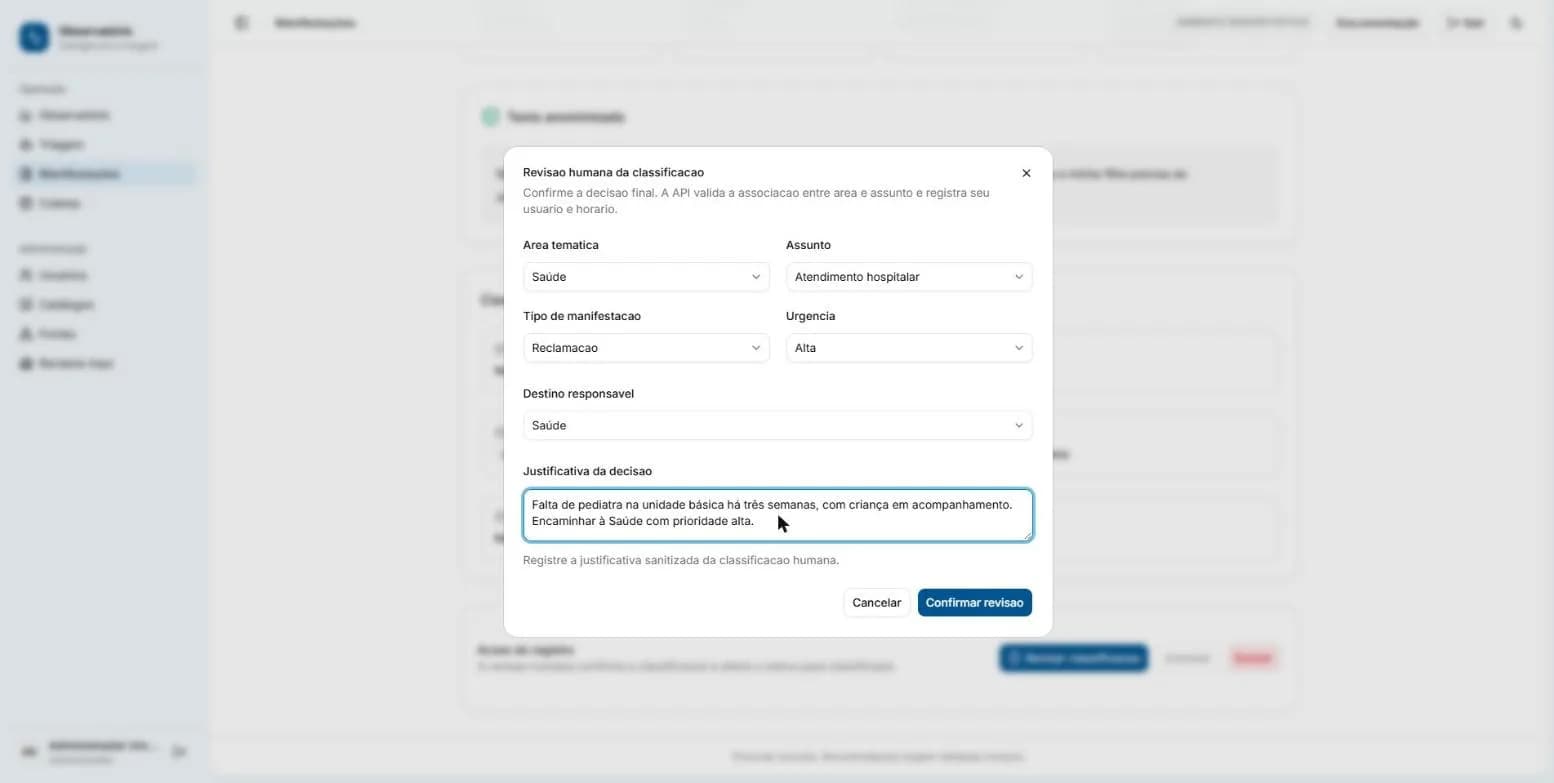
5. Coletas em segundo plano
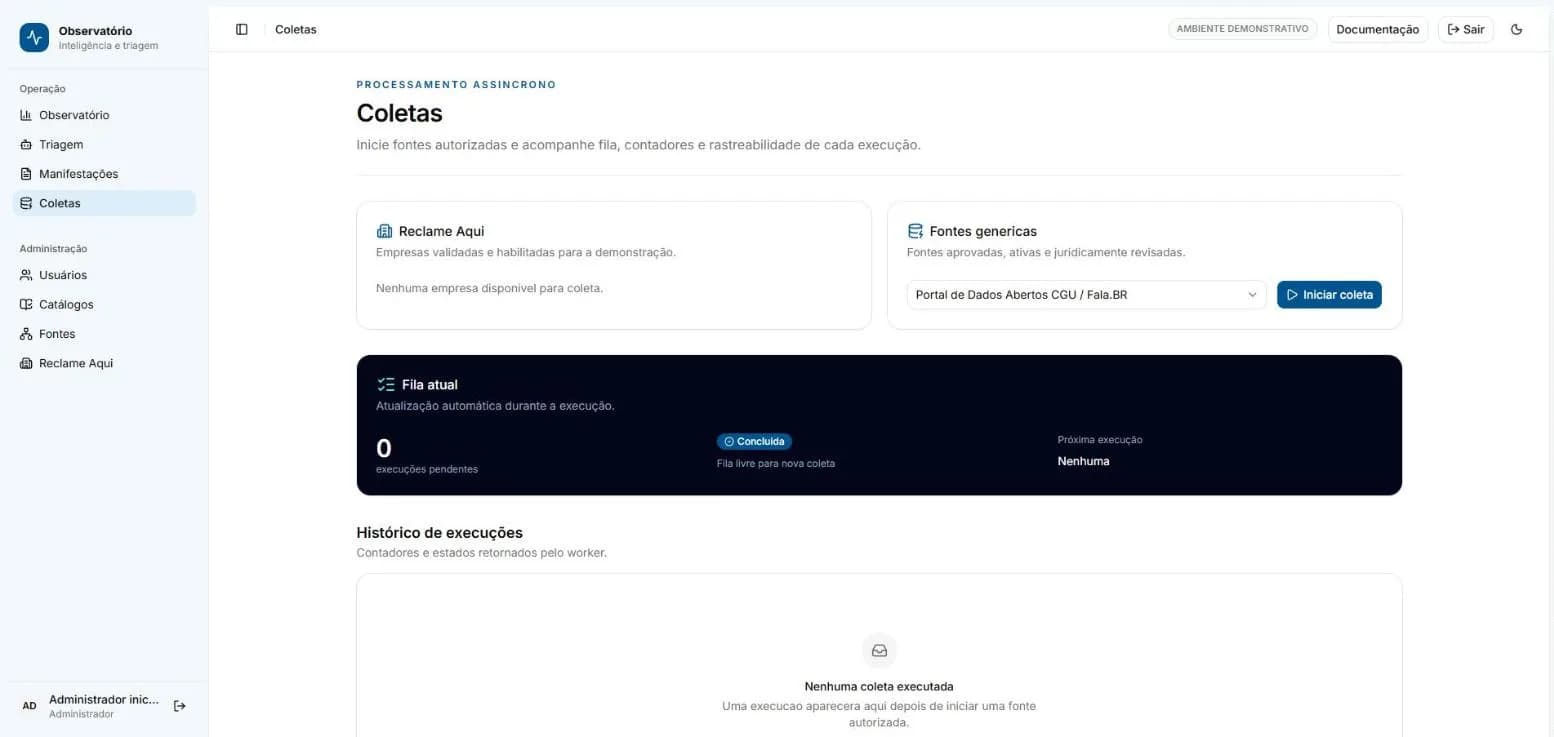
Além da digitação manual, o sistema busca manifestações em fontes públicas: o arquivo de dados abertos do Fala.BR (um ZIP com CSV), o portal de Dados Abertos de Minas Gerais (pela API de catálogo do portal) e o Reclame Aqui, lido com um navegador controlado pelo Playwright.
Coletar leva minutos, então não pode prender uma requisição HTTP. A API só registra uma execução como pendente e responde 202 Accepted. Um worker separado reivindica a próxima pendência com SELECT … FOR UPDATE SKIP LOCKED — assim, vários workers nunca pegam a mesma tarefa —, executa com tempo limite e número máximo de tentativas e confere o pedido de cancelamento a cada segundo.
Cada item coletado passa exatamente pelo mesmo caminho da triagem manual: anonimização, deduplicação e classificação. Os logs da execução guardam só metadados e contadores, nunca o conteúdo.
- Uma fonte só fica disponível se estiver ativa, aprovada e com termos de uso e robots.txt revisados — tudo registrado no cadastro da fonte.
- O coletor não tenta contornar login, CAPTCHA nem bloqueios de acesso.
- Se o worker cair no meio de uma coleta, ao reiniciar ele devolve as execuções interrompidas para a fila.
execution = db.scalar(
    select(CollectionExecution)
    .where(CollectionExecution.state == PENDING)
    .order_by(CollectionExecution.created_at)
    .with_for_update(skip_locked=True)  # nunca dois workers na mesma tarefa
    .limit(1)
)
execution.state = RUNNING
execution.started_at = datetime.now(timezone.utc)
db.commit()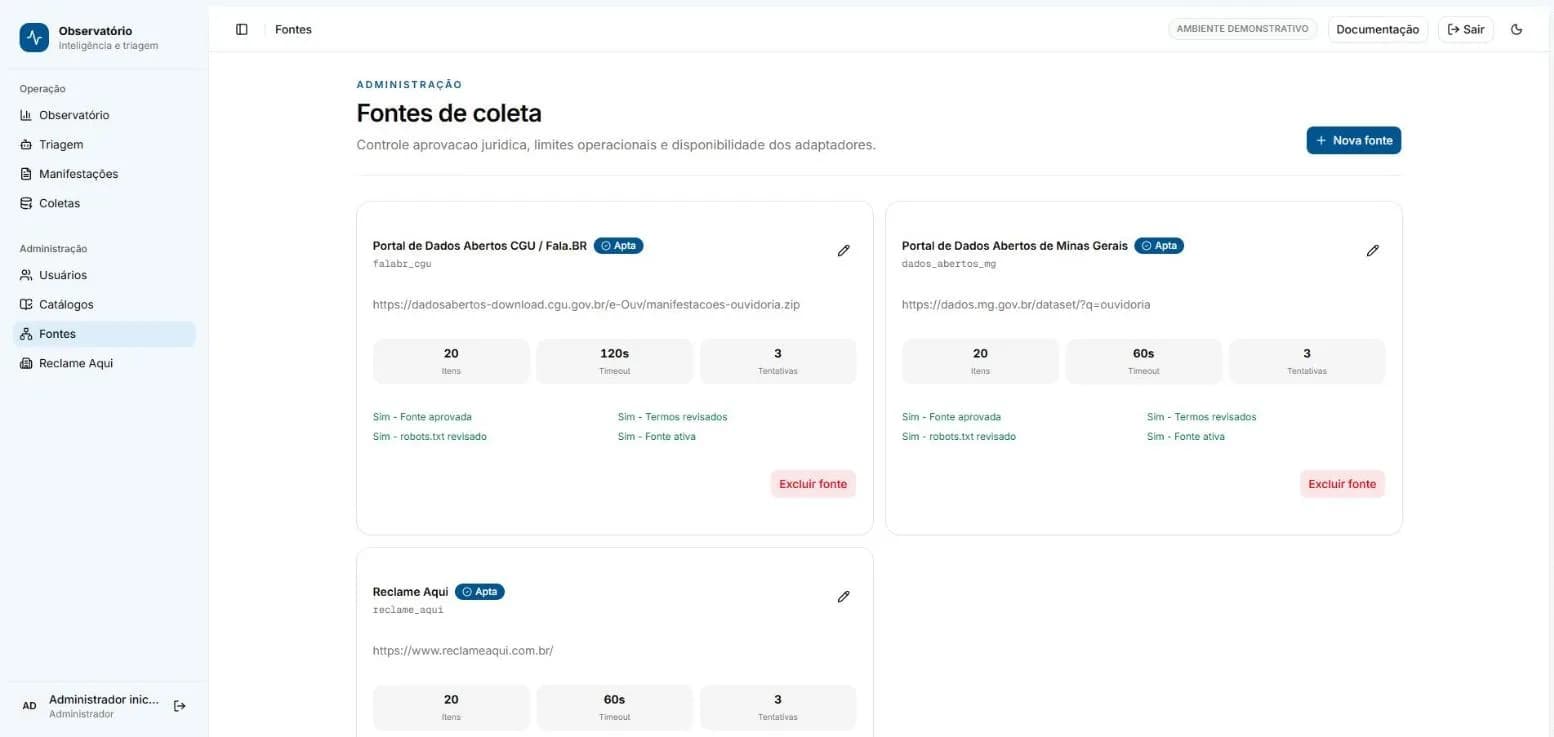
6. O observatório
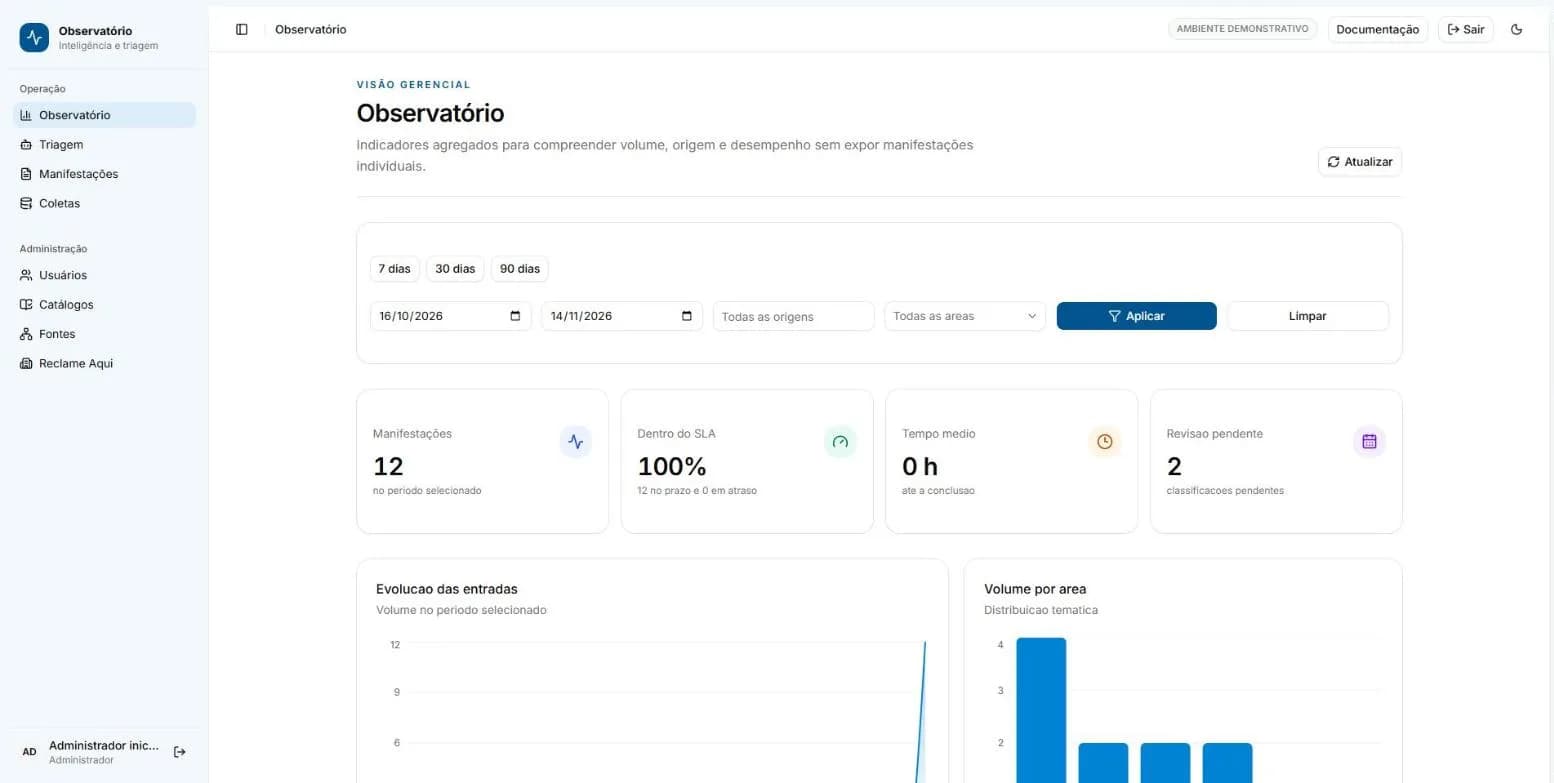
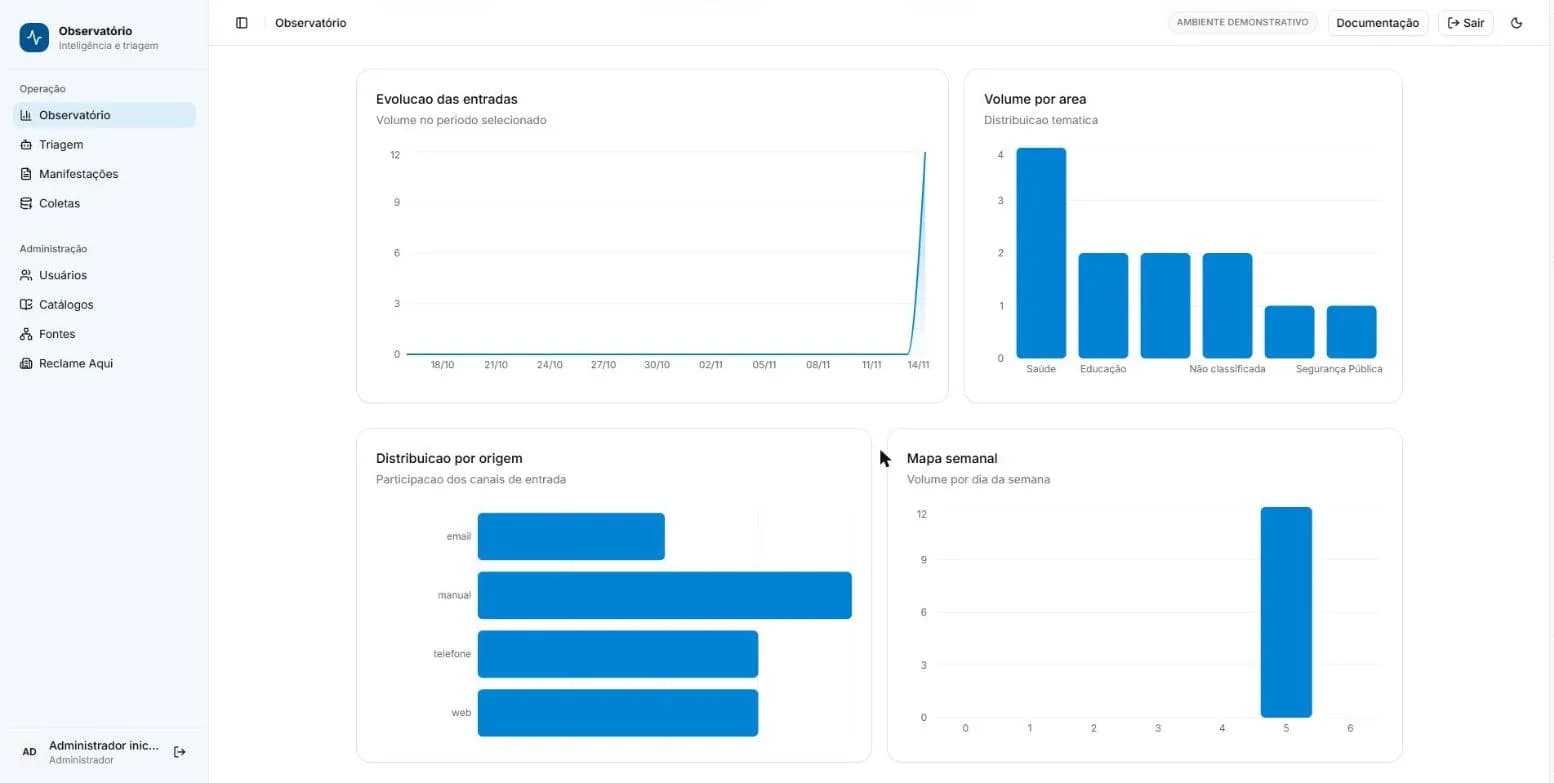
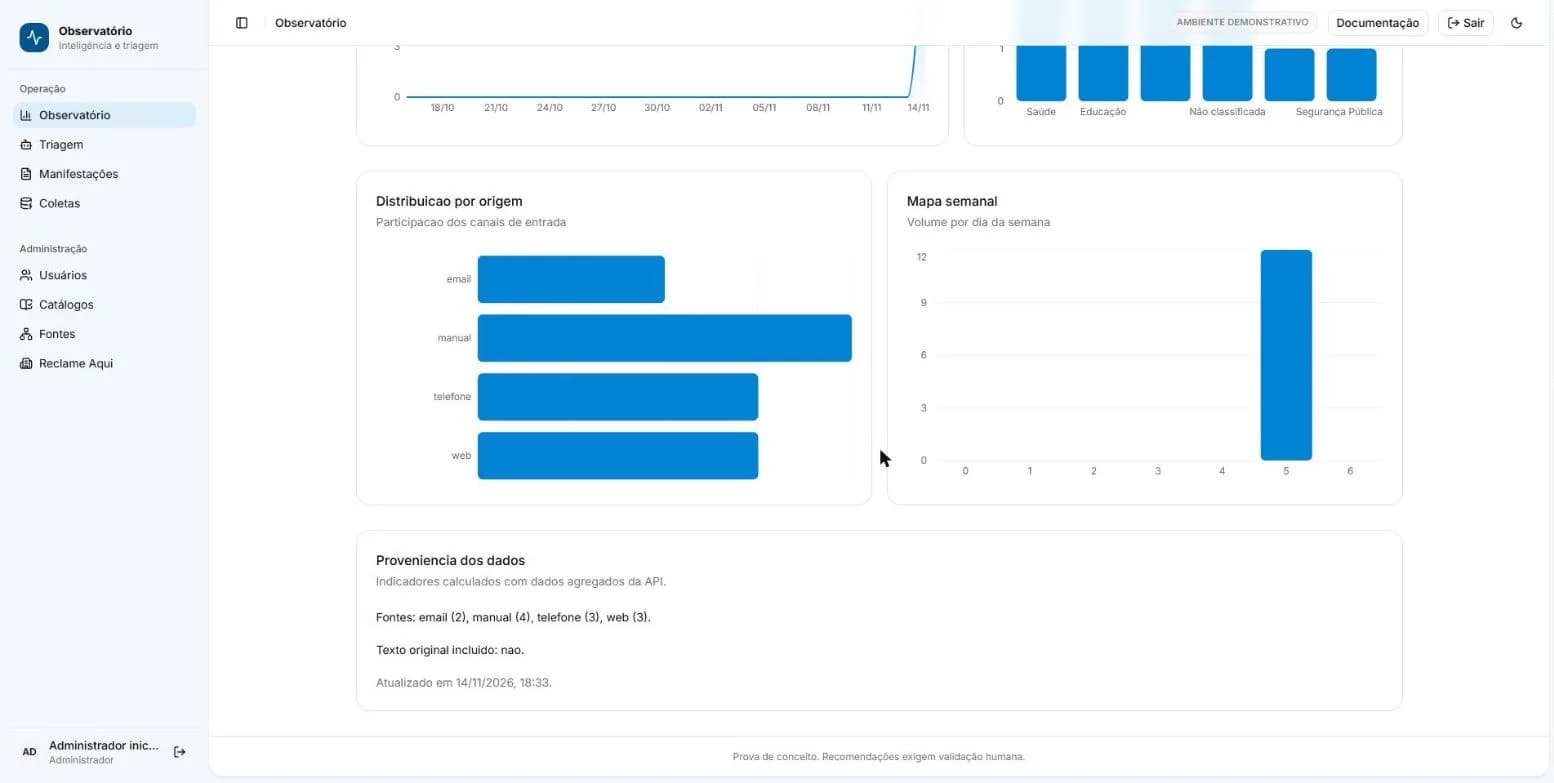
A tela do gestor responde perguntas de gestão: quantas manifestações chegaram, quantas estão dentro do prazo, quanto tempo levam para ser concluídas, o que ainda espera revisão, e como o volume se divide por área, canal e dia da semana.
O ponto central é o que o endpoint de indicadores não devolve: nenhum texto. Ele entrega só contagens, percentuais e séries, calculados no banco, junto com a proveniência — que filtros foram aplicados, quais fontes entraram na conta e quando foi atualizado. Os filtros ficam na URL, então uma visão pode ser compartilhada com um link.
Por trás das telas
O front é um monorepo com Turborepo: o app em Next.js 16 e React 19 e um pacote compartilhado de componentes (shadcn/Base UI). O TanStack Query cuida do estado vindo da API — uma revisão, por exemplo, invalida a lista e os indicadores. Formulários usam React Hook Form com Zod, e adaptadores validam cada resposta da API antes de ela chegar aos componentes.
A API é FastAPI com Pydantic, SQLAlchemy 2 e Alembic: PostgreSQL em produção, SQLite para rodar local. Os schemas aceitam nomes de campo em português e em inglês. Um middleware limita o tamanho do corpo (100 KB) e a taxa de triagens (30 por minuto, contadas no banco) e anexa um ID de correlação a cada requisição. A API e o worker são processos separados que compartilham o banco; tudo roda em Docker e é publicado com Dokploy.
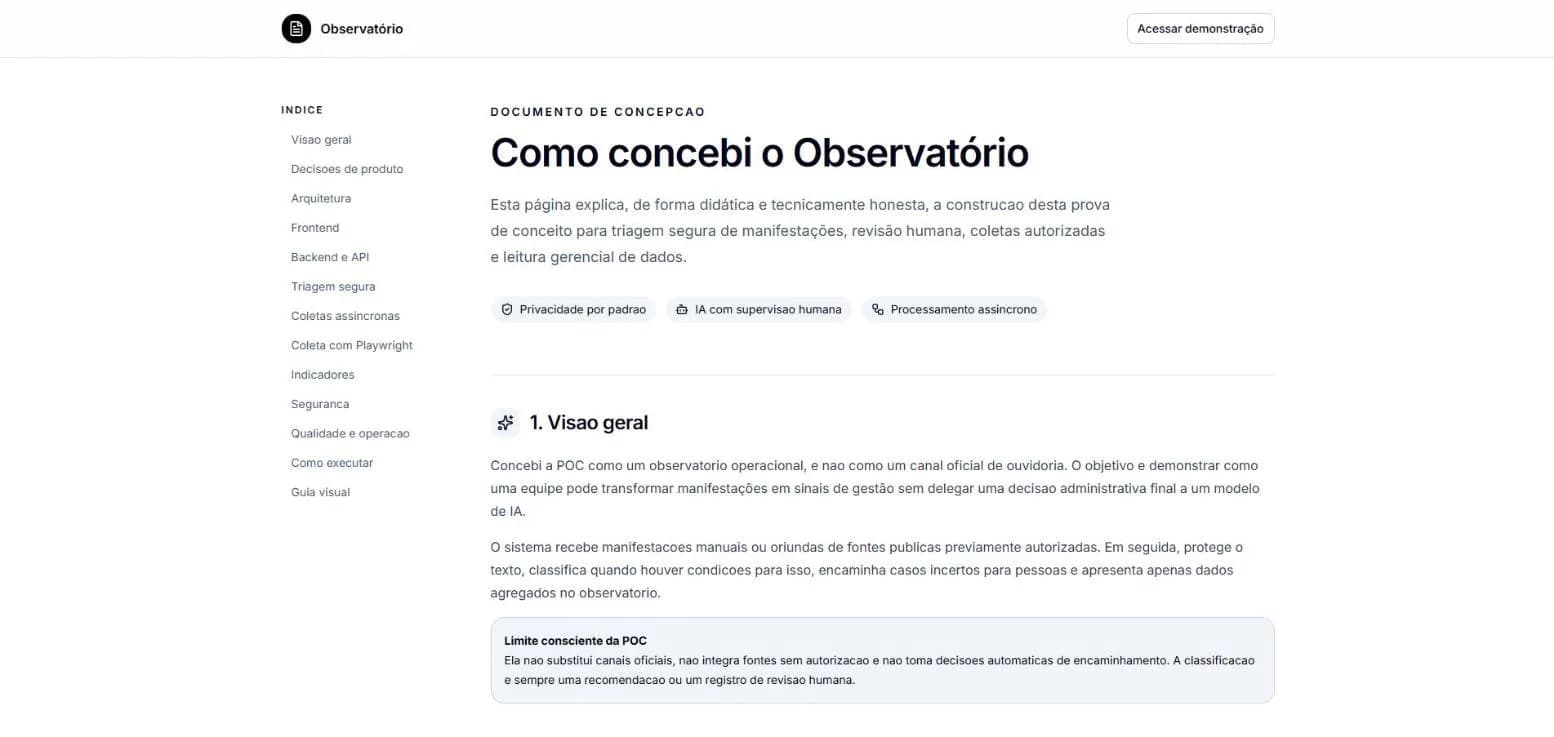
Escrevi também uma página pública de documentação dentro do próprio app, que explica arquitetura, decisões e limites para quem for avaliar o projeto. São 35 testes em Pytest — anonimização, segurança, manifestações, catálogos, coletas, worker e requisitos funcionais — e 6 em Vitest no front.
O que aprendi
Testar com textos reais mostrou o custo de errar para o lado seguro. O modelo de linguagem às vezes confunde palavras comuns com entidades: em “Liguei para a secretaria”, o “Liguei” virou <LOCATION>, e um nome próprio já saiu rotulado como local. O dado pessoal nunca vazou — mas o texto fica menos legível para quem revisa.
Foi uma escolha consciente: num sistema que lida com dados de cidadãos, mascarar demais é muito melhor do que mascarar de menos. O próximo passo é calibrar isso — restringir as entidades que o Presidio considera e ajustar os limiares de confiança — sem abrir mão das regras próprias, que pegam CPF, telefone e e-mail de forma determinística.
Para sair da prova de conceito, eu priorizaria criptografia e política de retenção para qualquer dado sensível autorizado, trilha de auditoria persistente, rate limit distribuído, SSO institucional e revisão jurídica de cada fonte.